Crawl là gì? Đây là quá trình bot của công cụ tìm kiếm truy cập website, đọc nội dung và theo dõi các liên kết để phát hiện URL cần xử lý.
Trong bài viết này, Indexnhanh sẽ giúp bạn hiểu cách Googlebot crawl website, các yếu tố ảnh hưởng đến quá trình thu thập dữ liệu và cách tối ưu crawl để hỗ trợ index hiệu quả hơn.
Tổng quan về Crawl
Crawl là gì?
Crawl là gì? Trong SEO, crawl là quá trình các công cụ tìm kiếm như Googlebot, Bingbot hay các bot khác truy cập vào website để đọc nội dung, phát hiện trang mới, cập nhật thay đổi và thu thập dữ liệu phục vụ cho việc lập chỉ mục.
Nói cách khác, khi bạn hỏi crawl là gì, có thể hiểu đơn giản rằng đây là bước đầu tiên để Google “biết” website của bạn tồn tại. Nếu không crawl được, trang web gần như không có cơ hội xuất hiện trên kết quả tìm kiếm, dù nội dung có hay đến đâu.
Với người mới, crawl nghĩa là gì có thể hiểu là “đi quét” website. Bot sẽ lần theo các đường dẫn, đọc nội dung HTML, phân tích liên kết nội bộ, sitemap, robots.txt và nhiều tín hiệu khác để quyết định trang nào nên được thu thập dữ liệu tiếp theo.
Trong thực tế SEO, khi nhắc đến crawl website là gì, người ta thường đang nói đến toàn bộ quá trình bot truy cập và khám phá cấu trúc website. Một website có cấu trúc rõ ràng, tốc độ tốt, ít lỗi kỹ thuật sẽ được crawl hiệu quả hơn.
Ngoài ra, crawl data là gì cũng là thuật ngữ thường gặp. Crawl data là dữ liệu được bot thu thập trong quá trình crawl, bao gồm nội dung trang, tiêu đề, mô tả, liên kết, mã trạng thái, thời gian phản hồi, canonical, robots directives và nhiều tín hiệu kỹ thuật khác.
Phân biệt Crawl và Scrap
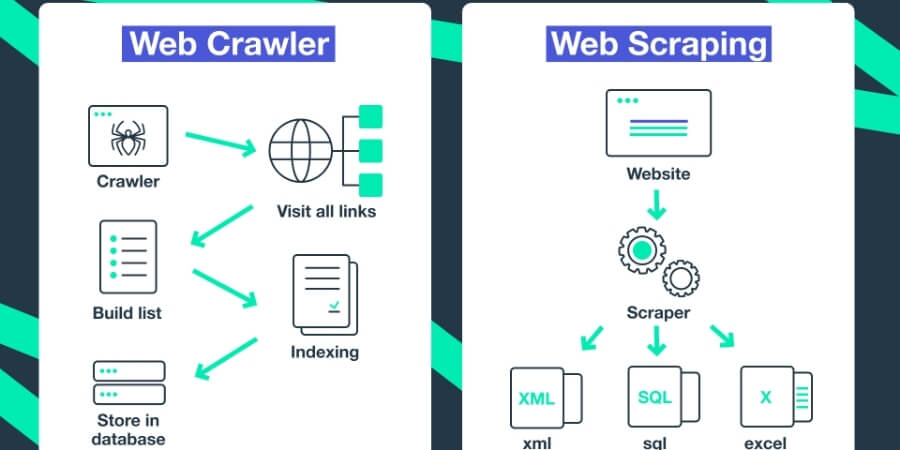
Nhiều người thường nhầm giữa crawl và scrap, nhưng đây là hai khái niệm khác nhau.
- Crawl là quá trình bot đi thu thập dữ liệu trên website theo liên kết hoặc nguồn chỉ dẫn.
- Scrap là quá trình lấy dữ liệu từ trang web sau khi đã truy cập, thường nhằm mục đích trích xuất và lưu lại nội dung.
Điểm khác biệt quan trọng là crawl phục vụ mục tiêu khám phá và thu thập dữ liệu, còn scrap thường thiên về sao chép hoặc trích xuất nội dung. Trong SEO, Google bot crawl để hiểu website, chứ không “scrap” theo nghĩa sao chép dữ liệu như các công cụ lấy nội dung tự động.
Nếu hiểu đúng crawl là gì, bạn sẽ dễ phân biệt vì sao một số trang được bot ghé thăm nhưng chưa chắc đã được index ngay, hoặc vì sao website có nhiều trang nhưng Google chỉ crawl một phần.
Crawl hoạt động như thế nào?
Tìm kiếm và lựa chọn trang web
Quá trình crawl bắt đầu khi bot tìm thấy một URL mới từ nhiều nguồn khác nhau như:
- Liên kết nội bộ trên website
- Backlink từ website khác
- Sitemap.xml
- Dữ liệu lịch sử từ những lần crawl trước
- Tín hiệu từ công cụ quản trị như Google Search Console
Khi bot phát hiện một URL, nó sẽ đánh giá xem có nên truy cập hay không. Đây là lý do tại sao hiểu crawl là gì không chỉ là hiểu bot “ghé thăm trang”, mà còn là hiểu cách bot ưu tiên trang nào trước, trang nào sau.
Google không crawl toàn bộ website một cách ngẫu nhiên. Bot sẽ cân nhắc:
- Độ uy tín của website
- Tốc độ phản hồi server
- Mức độ cập nhật nội dung
- Cấu trúc liên kết nội bộ
- Mức độ trùng lặp URL
- Chỉ dẫn từ robots.txt, meta robots, canonical
Với website lớn, crawl budget đóng vai trò rất quan trọng. Nếu website có quá nhiều URL rác, tham số, trang mỏng hoặc lỗi kỹ thuật, Google có thể lãng phí tài nguyên crawl vào những trang không mang lại giá trị.
Phân tích cấu trúc của website
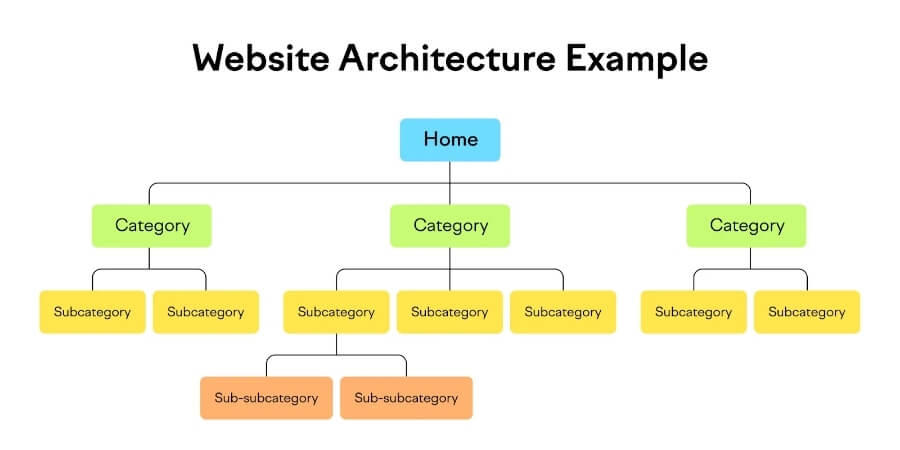
Sau khi truy cập trang, bot sẽ phân tích cấu trúc nội dung và mã nguồn HTML. Ở bước này, Googlebot đọc:
- Tiêu đề trang
- Heading
- Nội dung chính
- Link nội bộ và link ngoài
- Thuộc tính canonical
- Thẻ robots
- Dữ liệu có cấu trúc
- Hình ảnh, video, tài nguyên tải về
Hiểu crawl website là gì ở góc độ kỹ thuật cũng có nghĩa là hiểu bot không “nhìn” website như con người. Bot đọc dữ liệu theo cấu trúc mã nguồn, vì vậy nếu website render quá nặng, nội dung bị che khuất bởi JavaScript hoặc cấu trúc HTML kém, khả năng crawl sẽ giảm.
Đây là lý do SEO kỹ thuật ngày càng quan trọng trong năm 2026: website cần dễ crawl, dễ hiểu, dễ phân loại và dễ index.
Lưu trữ và cập nhật nội dung
Sau khi crawl, dữ liệu được chuyển sang hệ thống xử lý của công cụ tìm kiếm. Google sẽ đánh giá:
- Nội dung có mới không
- Nội dung có hữu ích không
- Có phải bản trùng lặp không
- Có phù hợp với truy vấn tìm kiếm nào
- Có đáng để index hay không
Nhiều người hỏi crawl là gì nhưng lại bỏ qua giai đoạn sau crawl. Thực tế, crawl chỉ là bước thu thập dữ liệu ban đầu. Sau đó Google mới quyết định có index hay không. Nghĩa là:
Crawl ≠ Index
Một trang có thể được crawl nhưng không được index nếu:
- Nội dung mỏng
- Trùng lặp cao
- Bị chặn bởi canonical
- Bị noindex
- Chất lượng thấp
- Không đủ tín hiệu hữu ích
Đây là điểm cốt lõi trong SEO hiện đại: muốn index tốt, trước tiên phải crawl tốt, nhưng crawl tốt chưa đủ.
Cách tối ưu Crawl hiệu quả cho SEO
Đảm bảo server phản hồi nhanh và ổn định
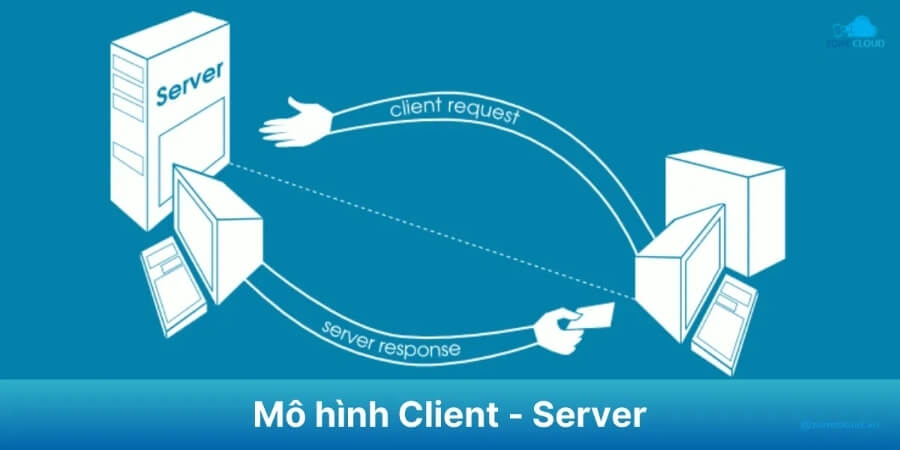
Tốc độ server ảnh hưởng trực tiếp đến khả năng crawl. Nếu server phản hồi chậm, thường xuyên lỗi 5xx hoặc quá tải, Googlebot sẽ giảm tần suất crawl để tránh gây áp lực lên hệ thống.
Một website muốn được crawl hiệu quả cần:
- Hosting/server ổn định
- Thời gian phản hồi nhanh
- Hạn chế lỗi 500, 502, 503
- Tối ưu TTFB
- Sử dụng CDN nếu phù hợp
- Giảm tài nguyên nặng không cần thiết
Về mặt SEO, hiểu crawl website là gì cũng là hiểu rằng website không chỉ cần nội dung tốt mà còn phải “dễ truy cập” với bot.
Loại bỏ các nội dung không có giá trị
Google ngày càng ưu tiên chất lượng và tính hữu ích. Vì vậy, các trang không có giá trị có thể làm giảm hiệu quả crawl toàn site.
Nên xem xét loại bỏ hoặc hợp nhất:
- Trang mỏng nội dung
- Trang trùng lặp
- Trang tag quá nhiều
- Trang lọc không cần index
- Trang tìm kiếm nội bộ
- Trang phân trang vô nghĩa
- Nội dung tự động sinh nhưng không hữu ích
Đây là bước quan trọng nếu bạn muốn tối ưu theo chuẩn Helpful Content và E.E.A.T. Một website càng nhiều nội dung rác, crawl càng bị phân tán.
Hướng dẫn Googlebot những nội dung không nên crawl
Bạn có thể hướng dẫn bot bằng nhiều cách:
- robots.txt
- meta robots noindex
- canonical
- cấu trúc internal link hợp lý
- hạn chế link tới URL không cần thiết
- điều chỉnh sitemap chỉ chứa URL quan trọng
Khi hiểu rõ crawl là gì, bạn sẽ thấy việc “hướng dẫn” bot quan trọng hơn “ra lệnh” bot. Google ưu tiên tín hiệu tổng thể của website, không chỉ một dòng chặn đơn lẻ.
Tối ưu file Sitemap.xml
Sitemap.xml là bản đồ website, giúp bot phát hiện URL quan trọng nhanh hơn.
Một sitemap tốt nên:
- Chỉ chứa URL có thể index
- Loại bỏ trang noindex
- Cập nhật thường xuyên
- Tách sitemap theo loại nội dung nếu website lớn
- Gửi lên Google Search Console
Sitemap không đảm bảo index, nhưng hỗ trợ mạnh cho quá trình crawl. Nếu website có nhiều trang mới, sitemap là một trong những tín hiệu giúp Googlebot tìm thấy nội dung nhanh hơn.
Hỗ trợ quá trình crawling bằng liên kết nội bộ
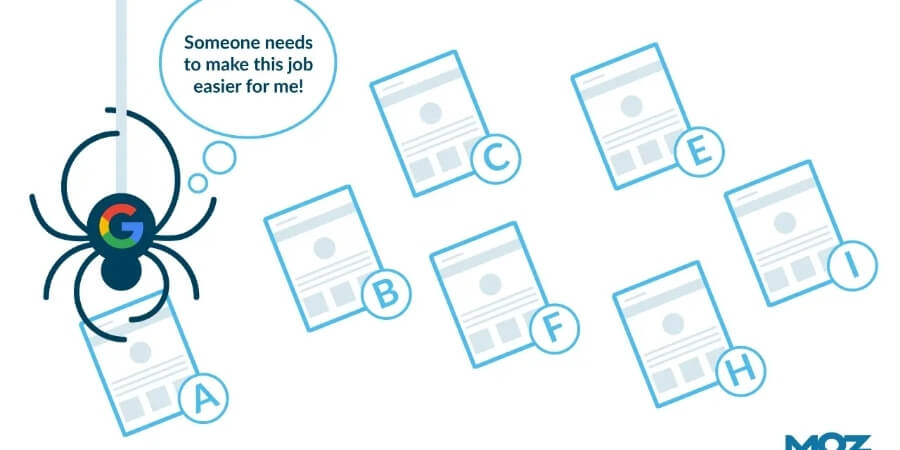
Internal link là một trong những yếu tố quan trọng nhất đối với crawl.
Liên kết nội bộ tốt sẽ giúp:
- Bot khám phá trang mới
- Truyền tín hiệu liên quan chủ đề
- Tăng khả năng crawl các trang quan trọng
- Giảm trang mồ côi
- Cải thiện cấu trúc website
Nếu bạn đang tối ưu SEO, hãy nhớ rằng crawl không chỉ phụ thuộc bot mà còn phụ thuộc cách bạn thiết kế đường đi cho bot. Một website có liên kết nội bộ logic sẽ được crawl hiệu quả hơn nhiều.
Câu hỏi thường gặp về Crawl
Vì sao một số trang web không được crawl?
Một số lý do phổ biến gồm:
- Bị chặn bởi robots.txt
- Không có liên kết nội bộ trỏ tới
- URL nằm sâu trong cấu trúc website
- Server phản hồi chậm hoặc lỗi
- Trang bị noindex
- Nội dung trùng lặp hoặc quá yếu
- Google chưa phát hiện ra URL
Làm thế nào để tối ưu website cho quá trình crawl?
Bạn có thể tối ưu bằng cách:
- Giữ cấu trúc website rõ ràng
- Tối ưu liên kết nội bộ
- Cập nhật sitemap.xml
- Loại bỏ URL rác
- Tăng tốc độ server
- Kiểm tra robots.txt và noindex
- Theo dõi Google Search Console thường xuyên
Cách kiểm tra Googlebot có crawl được website hay không?
Bạn có thể kiểm tra bằng:
- Google Search Console
- Kiểm tra file robots.txt
- Dùng URL Inspection để xem trạng thái index và crawl
- Xem log server để biết Googlebot truy cập URL nào
- Dùng công cụ crawl như Screaming Frog, Sitebulb hoặc các crawler kỹ thuật khác
Nếu bạn đang tối ưu SEO chuyên sâu, log file analysis là nguồn dữ liệu rất giá trị vì nó cho biết Googlebot thực sự crawl gì, bao nhiêu lần và ưu tiên trang nào.
Hiểu đúng Crawl là gì sẽ giúp bạn xây dựng nền tảng SEO kỹ thuật vững chắc hơn, bởi một trang muốn được index và có cơ hội xếp hạng trước hết cần được Googlebot phát hiện và thu thập dữ liệu đúng cách. Để tối ưu quá trình crawl, website cần có cấu trúc rõ ràng, sitemap XML sạch, robots.txt hợp lý, internal link logic, server ổn định, hạn chế URL trùng lặp, trang mỏng, lỗi 404, redirect chain và các tham số không cần thiết. Đồng thời, bạn nên theo dõi Google Search Console, kiểm tra URL Inspection và audit định kỳ để biết Googlebot đang crawl những khu vực nào trên website. Hy vọng những chia sẻ từ Indexnhanh sẽ giúp bạn hiểu rõ Crawl là gì, kiểm soát tốt dữ liệu Google thu thập và cải thiện khả năng index bền vững hơn cho website.
>>> Xem thêm chi tiết những bài viết liên quan
| Bạn có thể tìm hiểu Technical SEO để hiểu cách tối ưu các yếu tố kỹ thuật giúp website được thu thập dữ liệu, lập chỉ mục và hoạt động hiệu quả hơn. | Tìm hiểu Googlebot là gì sẽ giúp bạn hiểu cách bot của Google truy cập, thu thập và xử lý nội dung trên website. |
| Việc nắm rõ Crawl Budget giúp bạn biết cách tối ưu nguồn lực thu thập dữ liệu mà Google dành cho website. | Bạn có thể sử dụng URL Inspection để kiểm tra trạng thái lập chỉ mục và các vấn đề liên quan đến một URL cụ thể trên Google. |
| Tìm hiểu Render là gì sẽ giúp bạn hiểu cách công cụ tìm kiếm xử lý và hiển thị nội dung sau khi thu thập dữ liệu trang. | Việc hiểu JavaScript là gì giúp bạn nhận biết cách mã JavaScript có thể ảnh hưởng đến quá trình crawl, render và index website. |
